分布式训练 Line Loss异常
- Dominant language
- C++
- Stars
- 2.9k
- Forks
- 553
- PR merge metrics
- No merged PRs in 30d
Description
您好,感谢能开源这么好的框架,使用起来也非常方便,但是我在分布式训练Line时遇到个问题:
分布式(1ps+4worker)训练的loss变得非常大,我确定数据按分partitions的方式进行切分了,并进行了验证,确保没有问题,训练参数如下:
nohup python -m tf_euler \
--ps_hosts=xxx:1999 \
--worker_hosts=xxx:2000,xxx:2000,xxx:2000,xxx:2000 \
--job_name=worker \
--task_index=0 \
--data_dir hdfs:xxxxx/euler/test_data/ \
--model_dir=hdfs:x/euler/LINE_embedding \
--euler_zk_addr xxx:2181 \
--euler_zk_path /test_embedding \
--max_id 8428196 \
--learning_rate 0.001 \
--num_epochs 50 \
--batch_size 320000 \
--log_steps 20 \
--model line --mode train --dim 128 &
训练结果:
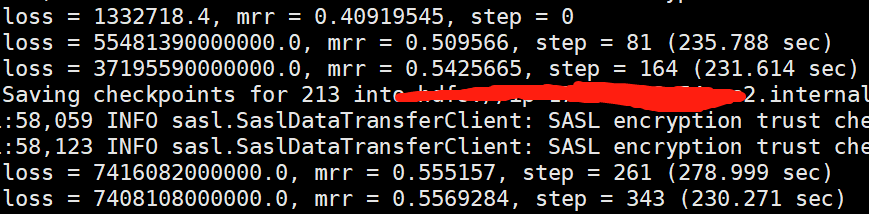
为什么loss 会变得这么大,我看好多关于line的提问,好像都有这个问题,
非常希望您能指导一下,
Contributor guide
No contributing guide indexed for this repository
Research direction
Start with the distributed `python -m tf_euler` LINE training command and compare its loss with a single-worker run using the same partitioned data and parameters. Inspect the `line` training entry point and worker/parameter-server logs; done means reproducing the discrepancy, identifying its cause, and documenting or validating the correction.
Written by the indexing model from the issue text.
Assessment
- Tech stack
- python
- Domain
- distributed-systems, machine-learning
- Issue type
- Bug
- Difficulty
- 4/5
- Estimated time
- 3-5 days
- Activity status
- Stale
- Clarity
- Needs clarification
- Newbie friendliness
- 25/100