NVIDIA-Merlin / NVIDIA-Merlin/Transformers4Rec
[BUG] Resume training after loading T4rec SavedModel
Open
Nobody has claimed this yet.
area/api
area/tensorflow
bug
P1
status/needs-triage
- Dominant language
- Python
- Stars
- 1.3k
- Forks
- 165
- Avg merge
- 1m
- Merged PRs (30d)
- 2
Description
Bug description
Calling the method fit after re-loading the model from disk raises the following issue:
_ _ _ _ _ _ _ _ _ _ _ _ _ _ _ _ _ _ _ _ _ _ _ _ _ _ _ _ _ _ _ _ _ _ _ _ _ _ _ _
../../opt/anaconda3/envs/recsys_trainer/lib/python3.8/site-packages/keras/engine/training.py:1184: in fit
    tmp_logs = self.train_function(iterator)
../../opt/anaconda3/envs/recsys_trainer/lib/python3.8/site-packages/tensorflow/python/eager/def_function.py:885: in __call__
    result = self._call(*args, **kwds)
../../opt/anaconda3/envs/recsys_trainer/lib/python3.8/site-packages/tensorflow/python/eager/def_function.py:933: in _call
    self._initialize(args, kwds, add_initializers_to=initializers)
../../opt/anaconda3/envs/recsys_trainer/lib/python3.8/site-packages/tensorflow/python/eager/def_function.py:759: in _initialize
    self._stateful_fn._get_concrete_function_internal_garbage_collected(  # pylint: disable=protected-access
../../opt/anaconda3/envs/recsys_trainer/lib/python3.8/site-packages/tensorflow/python/eager/function.py:3066: in _get_concrete_function_internal_garbage_collected
    graph_function, _ = self._maybe_define_function(args, kwargs)
../../opt/anaconda3/envs/recsys_trainer/lib/python3.8/site-packages/tensorflow/python/eager/function.py:3463: in _maybe_define_function
    graph_function = self._create_graph_function(args, kwargs)
../../opt/anaconda3/envs/recsys_trainer/lib/python3.8/site-packages/tensorflow/python/eager/function.py:3298: in _create_graph_function
    func_graph_module.func_graph_from_py_func(
../../opt/anaconda3/envs/recsys_trainer/lib/python3.8/site-packages/tensorflow/python/framework/func_graph.py:1007: in func_graph_from_py_func
    func_outputs = python_func(*func_args, **func_kwargs)
../../opt/anaconda3/envs/recsys_trainer/lib/python3.8/site-packages/tensorflow/python/eager/def_function.py:668: in wrapped_fn
    out = weak_wrapped_fn().__wrapped__(*args, **kwds)
_ _ _ _ _ _ _ _ _ _ _ _ _ _ _ _ _ _ _ _ _ _ _ _ _ _ _ _ _ _ _ _ _ _ _ _ _ _ _ _

args = (<tensorflow.python.data.ops.iterator_ops.OwnedIterator object at 0x7f82d08b8040>,)
kwargs = {}

    def wrapper(*args, **kwargs):
      """Calls a converted version of original_func."""
      # TODO(mdan): Push this block higher in tf.function's call stack.
      try:
        return autograph.converted_call(
            original_func,
            args,
            kwargs,
            options=autograph.ConversionOptions(
                recursive=True,
                optional_features=autograph_options,
                user_requested=True,
            ))
      except Exception as e:  # pylint:disable=broad-except
        if hasattr(e, "ag_error_metadata"):
>         raise e.ag_error_metadata.to_exception(e)
E         ValueError: in user code:
E
E             /Users/srabhi/opt/anaconda3/envs/recsys_trainer/lib/python3.8/site-packages/keras/engine/training.py:853 train_function  *
E                 return step_function(self, iterator)
E             /Users/srabhi/opt/anaconda3/envs/recsys_trainer/lib/python3.8/site-packages/keras/engine/training.py:842 step_function  **
E                 outputs = model.distribute_strategy.run(run_step, args=(data,))
E             /Users/srabhi/opt/anaconda3/envs/recsys_trainer/lib/python3.8/site-packages/tensorflow/python/distribute/distribute_lib.py:1286 run
E                 return self._extended.call_for_each_replica(fn, args=args, kwargs=kwargs)
E             /Users/srabhi/opt/anaconda3/envs/recsys_trainer/lib/python3.8/site-packages/tensorflow/python/distribute/distribute_lib.py:2849 call_for_each_replica
E                 return self._call_for_each_replica(fn, args, kwargs)
E             /Users/srabhi/opt/anaconda3/envs/recsys_trainer/lib/python3.8/site-packages/tensorflow/python/distribute/distribute_lib.py:3632 _call_for_each_replica
E                 return fn(*args, **kwargs)
E             /Users/srabhi/opt/anaconda3/envs/recsys_trainer/lib/python3.8/site-packages/keras/engine/training.py:835 run_step  **
E                 outputs = model.train_step(data)
E             /Users/srabhi/opt/anaconda3/envs/recsys_trainer/lib/python3.8/site-packages/keras/engine/training.py:791 train_step
E                 self.optimizer.minimize(loss, self.trainable_variables, tape=tape)
E             /Users/srabhi/opt/anaconda3/envs/recsys_trainer/lib/python3.8/site-packages/keras/optimizer_v2/optimizer_v2.py:522 minimize
E                 return self.apply_gradients(grads_and_vars, name=name)
E             /Users/srabhi/opt/anaconda3/envs/recsys_trainer/lib/python3.8/site-packages/keras/optimizer_v2/optimizer_v2.py:622 apply_gradients
E                 grads_and_vars = optimizer_utils.filter_empty_gradients(grads_and_vars)
E             /Users/srabhi/opt/anaconda3/envs/recsys_trainer/lib/python3.8/site-packages/keras/optimizer_v2/utils.py:72 filter_empty_gradients
E                 raise ValueError("No gradients provided for any variable: %s." %
E
E             ValueError: No gradients provided for any variable: ['head/item_id/list/embedding_weights:0', 'head/category/list/embedding_weights:0', 'head/sequential_block_1/tabular_sequence_features/kernel:0', 'head/sequential_block_1/tabular_sequence_features/bias:0', 'head/sequential_block_1/tabular_sequence_features/mlp_block_1/kernel:0', 'head/sequential_block_1/tabular_sequence_features/mlp_block_1/bias:0', 'head/sequential_block_1/tabular_sequence_features/causal_language_modeling/Variable:0', 'transformer_block/transformer/mask_emb:0', 'transformer_block/transformer/layer_._0/rel_attn/q:0', 'transformer_block/transformer/layer_._0/rel_attn/k:0', 'transformer_block/transformer/layer_._0/rel_attn/v:0', 'transformer_block/transformer/layer_._0/rel_attn/o:0', 'transformer_block/transformer/layer_._0/rel_attn/r:0', 'transformer_block/transformer/layer_._0/rel_attn/r_r_bias:0', 'transformer_block/transformer/layer_._0/rel_attn/r_s_bias:0', 'transformer_block/transformer/layer_._0/rel_attn/r_w_bias:0', 'transformer_block/transformer/layer_._0/rel_attn/seg_embed:0', 'transformer_block/transformer/layer_._0/rel_attn/layer_norm/gamma:0', 'transformer_block/transformer/layer_._0/rel_attn/layer_norm/beta:0', 'transformer_block/transformer/layer_._0/ff/layer_norm/gamma:0', 'transformer_block/transformer/layer_._0/ff/layer_norm/beta:0', 'transformer_block/transformer/layer_._0/ff/layer_1/kernel:0', 'transformer_block/transformer/layer_._0/ff/layer_1/bias:0', 'transformer_block/transformer/layer_._0/ff/layer_2/kernel:0', 'transformer_block/transformer/layer_._0/ff/layer_2/bias:0', 'transformer_block/transformer/layer_._1/rel_attn/q:0', 'transformer_block/transformer/layer_._1/rel_attn/k:0', 'transformer_block/transformer/layer_._1/rel_attn/v:0', 'transformer_block/transformer/layer_._1/rel_attn/o:0', 'transformer_block/transformer/layer_._1/rel_attn/r:0', 'transformer_block/transformer/layer_._1/rel_attn/r_r_bias:0', 'transformer_block/transformer/layer_._1/rel_attn/r_s_bias:0', 'transformer_block/transformer/layer_._1/rel_attn/r_w_bias:0', 'transformer_block/transformer/layer_._1/rel_attn/seg_embed:0', 'transformer_block/transformer/layer_._1/rel_attn/layer_norm/gamma:0', 'transformer_block/transformer/layer_._1/rel_attn/layer_norm/beta:0', 'transformer_block/transformer/layer_._1/ff/layer_norm/gamma:0', 'transformer_block/transformer/layer_._1/ff/layer_norm/beta:0', 'transformer_block/transformer/layer_._1/ff/layer_1/kernel:0', 'transformer_block/transformer/layer_._1/ff/layer_1/bias:0', 'transformer_block/transformer/layer_._1/ff/layer_2/kernel:0', 'transformer_block/transformer/layer_._1/ff/layer_2/bias:0', 'head/output_layer_bias:0'].

../../opt/anaconda3/envs/recsys_trainer/lib/python3.8/site-packages/tensorflow/python/framework/func_graph.py:994: ValueError
Steps/Code to reproduce bug
- This is the unit test (added in
test_model.py) that raises the error:
def test_resume_training_transformer_model(
    tf_next_item_prediction_model,
    yoochoose_schema,
    tf_yoochoose_like,
):
    yoochoose_schema = yoochoose_schema.select_by_name(
        ["item_id/list", "category/list", "timestamp/weekday/cos/list"]
    )
    model = tf_next_item_prediction_model(schema=yoochoose_schema)
    model.compile(optimizer="adam", run_eagerly=True)

    tf_yoochoose_like = dict(
        (name, tf_yoochoose_like[name]) for name in yoochoose_schema.column_names
    )
    dataset = tf.data.Dataset.from_tensor_slices(
        (tf_yoochoose_like, tf_yoochoose_like["item_id/list"])
    ).batch(50)

    inputs = next(iter(dataset))[0]
    model._set_inputs(inputs)
    _ = model.fit(dataset, epochs=1)

    with tempfile.TemporaryDirectory() as tmpdir:
           tf.keras.models.save_model(model,  tmpdir)
           model = tf.keras.models.load_model(tmpdir)

    losses = model.fit(dataset, epochs=1)
    assert all(loss >= 0 for loss in losses.history["loss"])
Expected behavior
- Being able to load the checkpoints from disk and resume training.
Environment details
- Transformers4Rec version: code from PR #317
- Python version: 3.8
- Huggingface Transformers version: 4.12.*
- Tensorflow version (GPU?): Yes (No)
Additional context
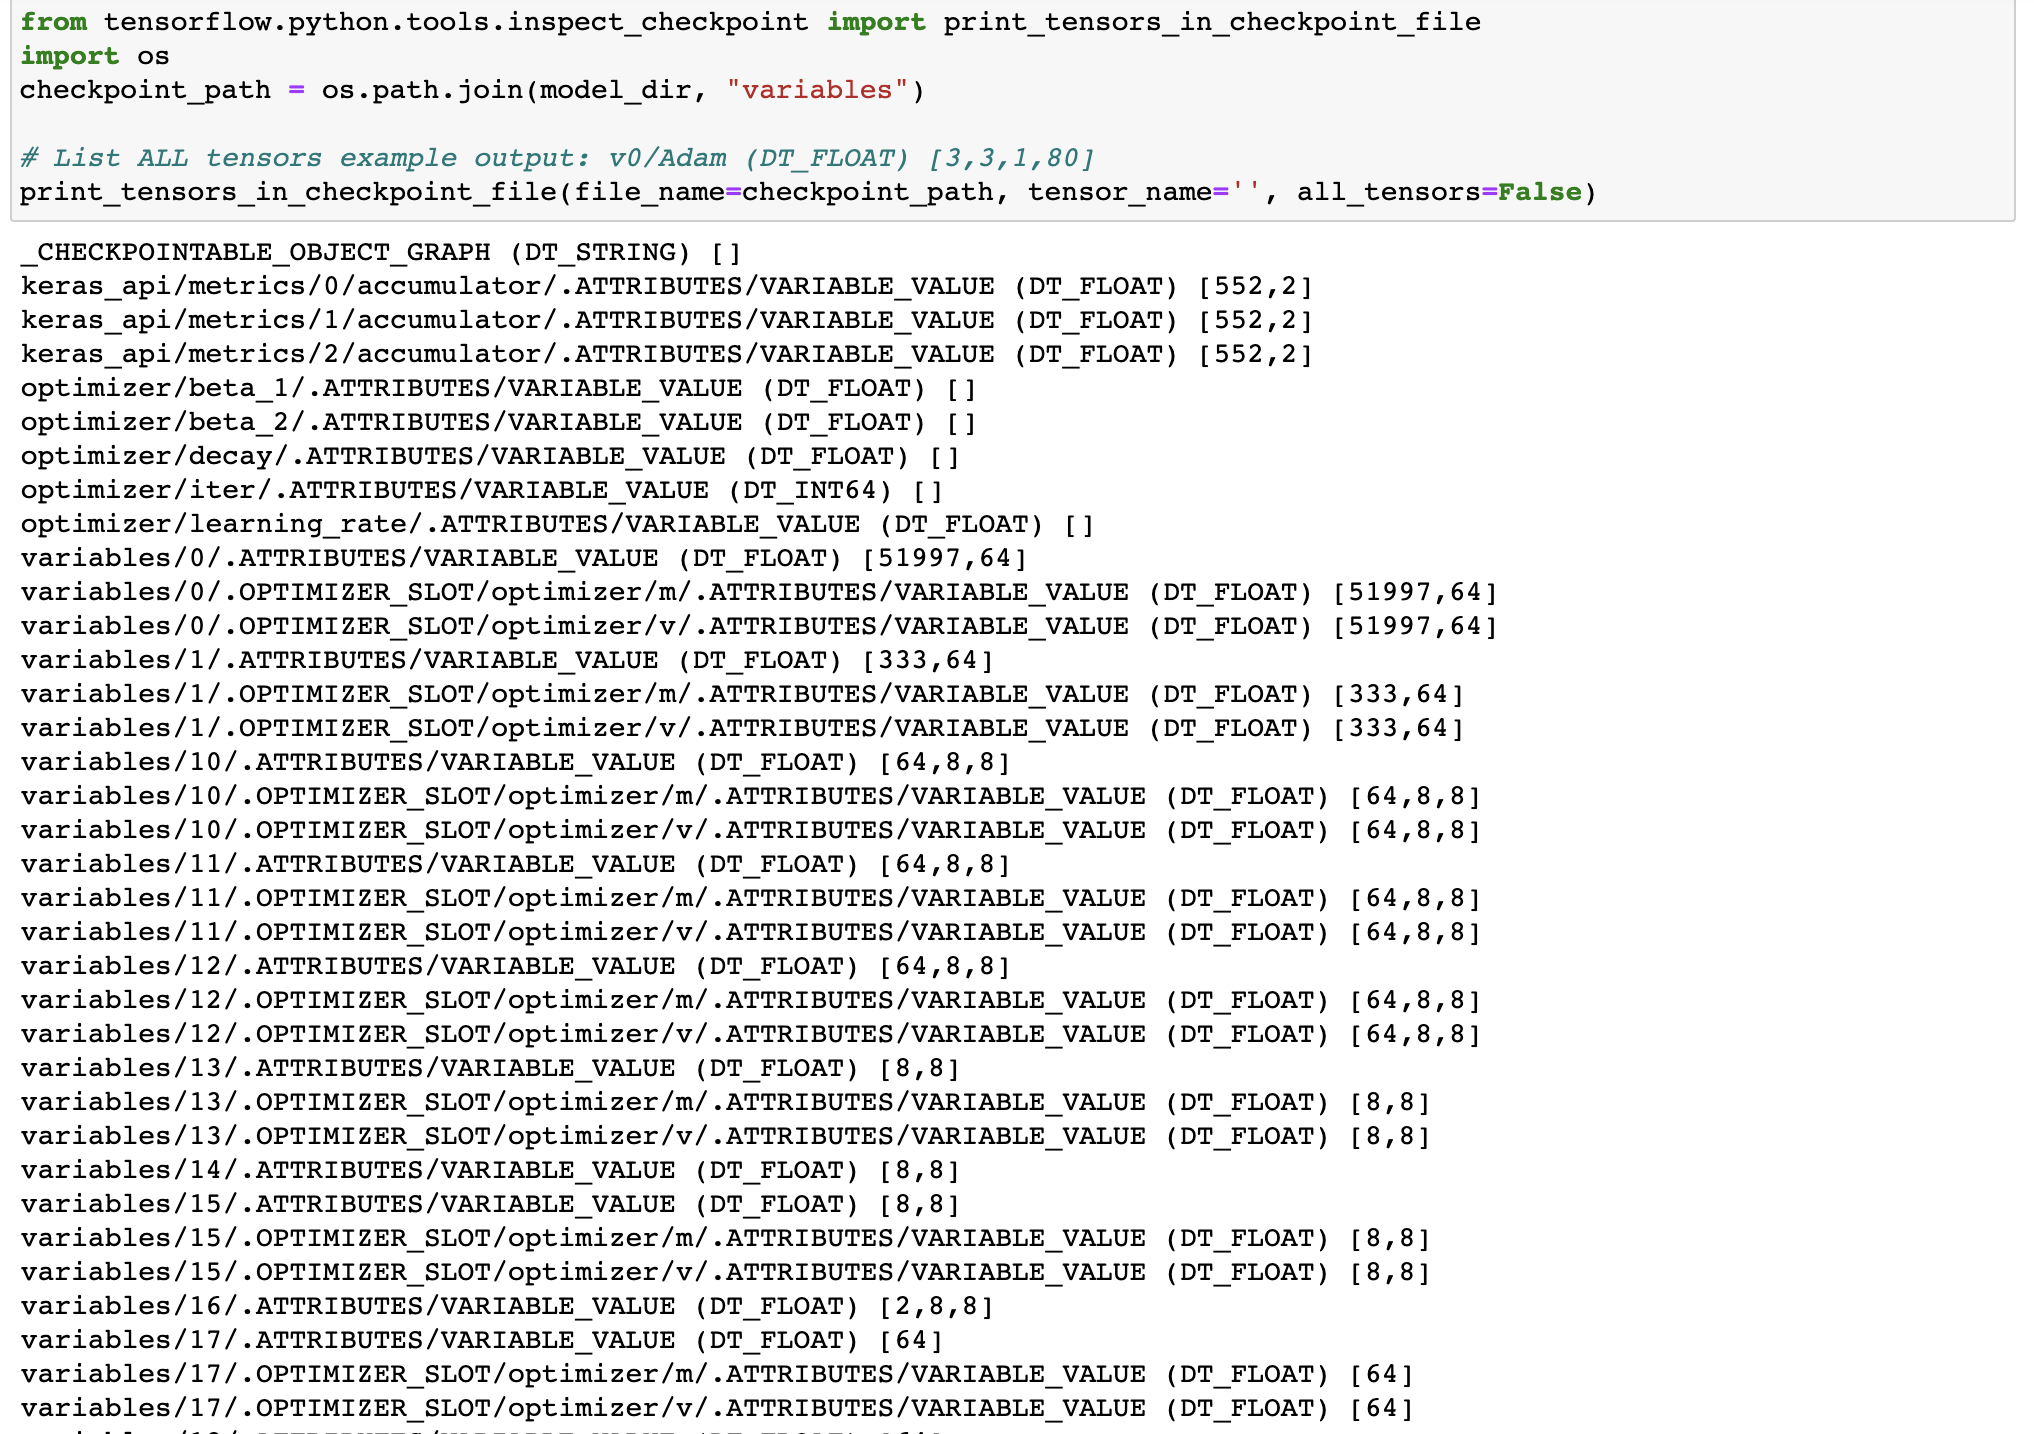
- The names of the variables in the model checkpoints are different from the names showed in the error stack :
Contributor guide
First steps
- Read the whole issue, then the project's contributing guide.
- Comment on the issue to say you are picking it up — it saves two people doing the same work.
- Fork the repository and make your change on a branch.
- Open a pull request that references the issue number.
Research direction
Start with the test_resume_training_transformer_model test in test_model.py and run its save/load sequence to reproduce the missing-gradients error. Compare the model state before and after tf.keras.models.save_model and tf.keras.models.load_model. Done means the loaded model can fit for another epoch and produces nonnegative loss values.
Written by the indexing model from the issue text.
Assessment
- Tech stack
- python
- Domain
- machine-learning, testing-qa
- Issue type
- Bug
- Difficulty
- 4/5
- Estimated time
- 3-5 days
- Activity status
- Stale
- Clarity
- Mostly clear
- Newbie friendliness
- 35/100