Senario
- Dominant language
- Java
- Stars
- 0
- Forks
- 0
- PR merge metrics
- No merged PRs in 30d
Description
## 두 가지 시나리오
### 첫번째 시나리오
성향이 비슷한 Developer끼리 Clustering해서 학습시킨 Local Model이 기존의 방식보다 성능이 뛰어나다는 것을 입증한다. 단순히 연구 가치가 있다는 것을 시사하는 것이 목적이기 때문에 세세한 학습 기간과 테스트 기간 설정은 생략된다.
10-fold로 테스트한다.
예를 들어 10-fold Cross Validation을 할 때 1번 데이터 셋이 실험 데이터 셋이고, 2-10번 데이터 셋이 학습 데이터 셋이라고 해보자.
1번 데이터 셋에 있는 하나의 Change를 예측하기 위해서는 우선 그 개발자가 2-10번 데이터 셋에 존재하는 개발자 클러스터 중 어디에 속하는지 확인하고, 그 클러스터를 위한 로컬 모델을 통해 예측한다. 이것을 1번부터 10번까지 반복해서 나온 평균 정확도 값을 기존의 방식으로 했을 때의 값과 비교한다.
### 두번째 시나리오
학습 데이터 셋과 실험 데이트 셋의 기간을 정한다.
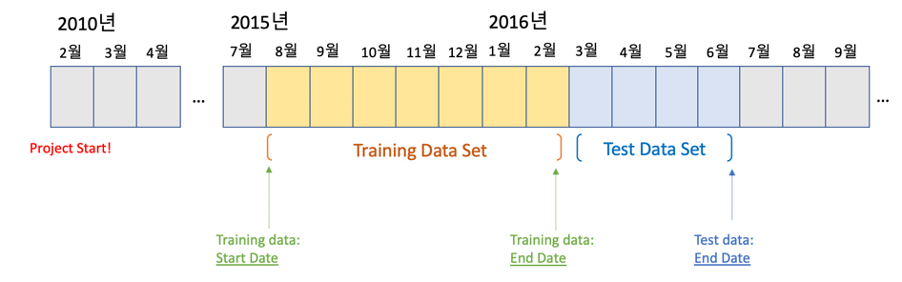
기간을 나누는데 필요한 날짜는 총 세 개다.
Training Data Set에 있는 개발자별 클러스터 학습 모델을 이용한다. Test Data Set에 있는 Change마다 속한 클러스터 모델로 예측한다.
### 학습 데이터에서 없는 개발자가 실험 데이터에 존재한다면?
1. 실험 데이터 셋에 있는 개발자의 데이터를 학습 데이터 클러스터로 클러스터링한다.
2. 무시한다.
Contributor guide
No contributing guide indexed for this repository
Assessment
This issue has not been assessed yet.